GetDown ist live. Ich habe einen kostenlosen Open-Source-Web-Downloader gebaut, mit dem Du Medienlinks als MP4-Videos oder MP3-/M4A-Audiodateien speichern kannst – ohne Desktop-App, Registrierung oder komplizierte Terminalbefehle.
Ich mag yt-dlp. Das Projekt ist enorm leistungsfähig. Aber für einen schnellen Download jedes Mal das Terminal zu öffnen, Formate nachzuschlagen, Streams auszuwählen und Dateien zu konvertieren, ist häufig unnötig umständlich. Ich wollte die bewährte Technik behalten und ihr eine einfache Oberfläche geben.
Das Ergebnis ist GetDown: eine Weboberfläche für yt-dlp und FFmpeg mit echten Download-Jobs, Fortschrittsanzeige, temporären Dateien und Self-Hosting. Der Quellcode steht unter der MIT-Lizenz auf GitHub.
GetDown ausprobieren · Quellcode auf GitHub
So funktioniert GetDown
- Medienlink einfügen. GetDown fragt über yt-dlp zuerst die Metadaten ab, statt sofort etwas herunterzuladen.
- Vorschau prüfen. Wenn die Quelle erreichbar ist, erscheinen Titel, Vorschaubild, Urheber bzw. Kanal, Dauer und verfügbare Auflösungen.
- Format auswählen. Video als MP4 speichern oder Audio als MP3 beziehungsweise M4A extrahieren. Bei Videos kannst Du die beste verfügbare Qualität oder eine maximale Auflösung wählen.
- Datei herunterladen. Die Warteschlange zeigt Status, Fortschritt, Geschwindigkeit und geschätzte Restzeit. Jobs lassen sich abbrechen; nach Abschluss gibt es einen zeitlich begrenzten Downloadlink.
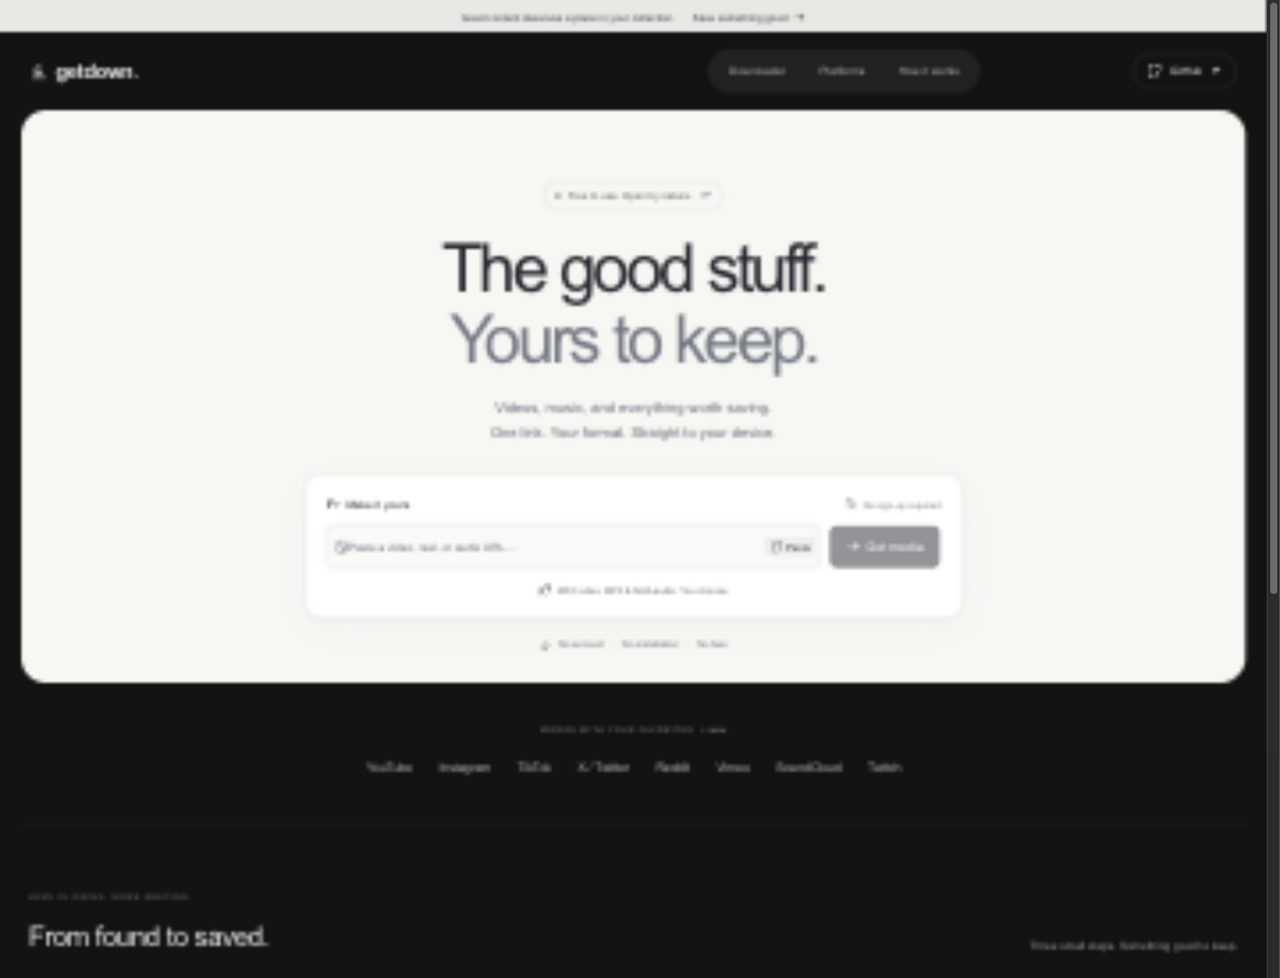
Mir sind auch die Details wichtig: Links lassen sich direkt aus der Zwischenablage einfügen. Bei Fehlern bekommst Du eine verständliche Rückmeldung. Nach einem Neuladen der Seite kann der aktuelle Job anhand einer in der Browsersitzung gespeicherten ID wieder angezeigt werden – sofern der Server diesen Job noch kennt. Und die Oberfläche funktioniert auch auf dem Smartphone.
Welche Funktionen sind enthalten?
| Funktion | Umsetzung |
|---|---|
| Video | MP4 mit wählbarer maximaler Auflösung, abhängig von der Quelle |
| Audio | MP3- und M4A-Extraktion beziehungsweise -Konvertierung |
| Vorschau | Titel, Kanal, Dauer, Vorschaubild und verfügbare Auflösungen |
| Downloads | Warteschlange, Fortschritt, Geschwindigkeit, Restzeit, Abbruch und temporäre Dateilinks |
| Zugang | Keine Registrierung und keine Benutzerkonten |
| Tracking | Keine eingebauten Analytics- oder Werbetracker |
| Hosting | Docker Compose und eine separat abgesicherte Dokploy-Konfiguration |
| Lizenz | MIT für GetDown; die Abhängigkeiten haben eigene Lizenzen |
GetDown ist keine neue Download-Engine. Ich nutze bewusst die Extraktoren von yt-dlp und die Medienverarbeitung von FFmpeg. So kann ich mich auf die Bedienung konzentrieren, statt zwei ausgereifte Open-Source-Projekte neu zu erfinden.
Die Technik dahinter
Die Anwendung basiert auf Next.js 16, React 19, TypeScript und Tailwind CSS 4. Das Backend startet yt-dlp als separaten Prozess, um Medien zu untersuchen und herunterzuladen. FFmpeg übernimmt bei Bedarf das Zusammenführen von Streams und die Audio-Konvertierung.
Der Ablauf ist übersichtlich: Browser → Next.js-API → yt-dlp → FFmpeg (bei Bedarf) → temporäre Datei → Browser-Download.
Ein Auftrag durchläuft die Zustände queued, downloading, processing und completed – oder endet mit failed beziehungsweise cancelled. Die Fortschrittswerte stammen von yt-dlp und werden vom Browser regelmäßig abgefragt. Die Nachbearbeitung wird getrennt angezeigt, weil das Zusammenführen von Bild und Ton oder eine Konvertierung nach dem eigentlichen Download noch dauern kann.
Die Warteschlange und die Jobinformationen liegen derzeit im Arbeitsspeicher; die Dateien liegen temporär auf dem Server. Für eine kleine einzelne Instanz ist das bewusst einfach gehalten. Es bedeutet aber auch: Ein Serverneustart unterbricht laufende Aufträge. Mehrere parallele App-Instanzen wären ohne gemeinsamen Speicher und eine andere Queue-Architektur nicht zuverlässig. Redis/BullMQ oder verteilte Worker sind aktuell nicht eingebaut.
Im README sind API-Endpunkte, Konfiguration und Architektur dokumentiert.
Live-Betrieb mit Dokploy und Cloudflare
GetDown läuft öffentlich unter down.livvux.dev. Ich hoste die Anwendung über Dokploy; Cloudflare sitzt davor. Im Deployment gibt es eine App-Instanz hinter einem Ingress-Dienst und zusätzlich einen eigenen Proxy für ausgehende Verbindungen.
Die zusätzliche Trennung ist wichtig. Ein öffentlicher Downloader verarbeitet Links, die beliebige Besucher eingeben. Selbst eine Liste erlaubter Domains reicht nicht als alleinige SSRF-Schutzmaßnahme, weil yt-dlp Weiterleitungen folgen oder weitere Dateien und Manifeste von anderen Hosts abrufen kann.
Deshalb läuft die Anwendung in einem internen Docker-Netzwerk. Ausgehende yt-dlp-Anfragen müssen über einen Proxy laufen, der private, lokale, Link-Local- und weitere reservierte Zieladressen sperrt. Die Container laufen außerdem mit eingeschränkten Berechtigungen und schreibgeschützten Dateisystemen.
Das ist mehrschichtige Absicherung, aber kein Versprechen, dass jeder denkbare Missbrauch ausgeschlossen ist. Ein öffentlich erreichbarer Downloader braucht weiterhin Ressourcenlimits, Rate-Limits, Monitoring und regelmäßig aktualisierte Extraktoren.
Ich habe die öffentliche Instanz bewusst begrenzt:
| Einstellung der Live-Instanz | Limit |
|---|---|
| Gleichzeitige Downloads | 1 |
| Wartende Aufträge | 4 |
| Maximale Ausgabedatei | 100 MB |
| Maximale bekannte Mediendauer | 30 Minuten |
| Zeitlimit pro Job | 10 Minuten |
| Aufbewahrung fertiger Dateien | 15 Minuten |
Wichtig: GetDown ist kein dauerhafter Cloud-Speicher. Fertige Downloads werden nach begrenzter Zeit entfernt. Beim Neustart des öffentlichen Containers wird auch der temporäre Dateispeicher verworfen. GetDown benötigt keine Konten und hat keine eingebauten Analytics; die Quellplattform sieht allerdings die serverseitige Anfrage, und der jeweilige Betreiber kontrolliert seine Serverinfrastruktur.
Was wurde wirklich getestet?
Zum Launch wurden HTTPS, der Healthcheck, Desktop- und Mobile-Ansicht sowie die ausgehenden Netzwerksperren geprüft. Echte Downloads im MP4- und MP3-Format waren erfolgreich; die erzeugten Dateien wurden mit FFprobe validiert. Auch die CI-Prüfungen waren für den veröffentlichten Code erfolgreich.
Damit sind funktionierende End-to-End-Downloads von den getesteten öffentlichen Quellen belegt. Es bedeutet ausdrücklich nicht, dass jeder Link jeder Plattform funktioniert.
YouTube, Vimeo und Plattform-Sperren
Die URL-Allowlist von GetDown enthält unter anderem YouTube, TikTok, Instagram, X/Twitter, Reddit, Vimeo, Twitch und SoundCloud sowie weitere Plattformen. Eine freigegebene Domain bedeutet lediglich, dass GetDown versucht, den Link zu verarbeiten. Es ist keine Erfolgsgarantie.
Zwei konkrete Einschränkungen aus den Launch-Tests:
| Getestete Quelle | Ergebnis |
|---|---|
| YouTube | Die Server-IP wurde zur Bot-Bestätigung aufgefordert. Der Download war nicht möglich. |
| Vimeo | Das getestete Video erforderte einen Login. Der Download war nicht möglich. |
| Öffentliches Testmaterial | MP4- und MP3-Downloads erfolgreich; Ausgabedateien mit FFprobe geprüft. |
Es gibt bewusst keinen Umweg über Benutzer-Cookies, Konto-Logins oder eine Umgehung der Bot-Bestätigung. Private, DRM-geschützte, geografisch gesperrte oder authentifizierungspflichtige Videos können daher nicht funktionieren. Playlists, Livestreams und Bildergalerien werden in der aktuellen Version ebenfalls nicht unterstützt.
yt-dlp kennt sehr viele Plattformen. Deren Regeln, Änderungen und Bot-Schutzmechanismen liegen aber außerhalb meiner Kontrolle. Lieber zeige ich eine korrekte Fehlermeldung, als pauschal Downloads von jeder Plattform zu versprechen.
GetDown selbst hosten
Zum lokalen Ausprobieren reicht Docker Compose:
git clone https://github.com/Livvux/getdown.git
cd getdown
docker compose up -d --build
Anschließend erreichst Du die App unter http://localhost:3000. Der Healthcheck liegt unter http://localhost:3000/api/health.
Für die Entwicklung ohne Docker dokumentiert das Repository alternativ eine Installation mit Node.js 22+, Python-yt-dlp und FFmpeg im PATH.
Wichtig: Das einfache Compose-Setup ist für den lokalen Betrieb gedacht und ersetzt keine abgesicherte öffentliche Bereitstellung. Wenn Du GetDown im Internet erreichbar machst, beachte die Anleitung zur Produktionsisolierung und sperre unerlaubte ausgehende Netzwerkziele auf Infrastrukturebene. Eine Eingabevalidierung allein deckt nicht alle Anfragen ab, die ein Extraktor später auslösen kann.
Warum Open Source?
Ich möchte für ein einfaches Medienwerkzeug weder ein Abo noch eine geschlossene Download-API benötigen. GetDown selbst steht unter MIT. Du kannst den Code prüfen, verändern, forken und auf Deiner eigenen Infrastruktur betreiben. Für yt-dlp und FFmpeg gelten weiterhin deren jeweilige Lizenzen.
Dabei gilt natürlich: Lade nur Medien herunter, die Dir gehören oder die Du speichern darfst. Beachte Urheberrecht und Nutzungsbedingungen der jeweiligen Plattform. GetDown umgeht keinen DRM-Schutz.
Mein Ziel ist kein Downloader, der angeblich jede Sperre austrickst. Ich wollte einen vorhandenen Open-Source-Workflow einfacher machen und offenlegen, was schon funktioniert und was noch nicht. Wer eine unkomplizierte Oberfläche möchte, kann GetDown direkt ausprobieren. Wer mehr Kontrolle will, kann den Quellcode selbst betreiben oder zum Projekt beitragen.
GetDown öffnen · Quellcode und Issues · Self-Hosting und Sicherheit
Projekt- und Deployment-Stand: 17. Oktober 2026. Verfügbarkeit einzelner Plattformen und Limits der öffentlichen Instanz können sich ändern.