Bessere Ergebnisse, weniger Wartezeit und kürzere Ausgaben. Genau solche Modell-Updates wünsche ich mir für Coding-Agenten.
DeepSeek hat DeepSeek-V4.1-Flash-1017 am 17. Oktober 2026 angekündigt: mit besseren Benchmark-Ergebnissen, kürzeren Aufgabenlaufzeiten und kürzeren Ausgaben. Laut offiziellem Changelog ist das Update auf der Website, in der App und über die API verfügbar. Bestehende Integrationen verwenden weiterhin deepseek-flash, zu denselben Token-Preisen.
Die Model Card bezeichnet die Veröffentlichung als kleines Update für V4.1 Flash. Einige der veröffentlichten Fortschritte fallen deutlich aus, besonders bei Terminal- und Programmieraufgaben. Mir gefällt die Kombination aus Verbesserungen für Agenten und herunterladbaren Modellgewichten.
Das ist meine Einschätzung der Veröffentlichungsunterlagen. Die folgenden Benchmark- und Effizienzangaben stammen von DeepSeek; ich habe das Modell nicht unabhängig evaluiert.
Was ändert sich mit dem Update vom 17. Oktober?
DeepSeek stellt drei Verbesserungen heraus: bessere Ergebnisse in den ausgewählten Benchmarks, schnellere Aufgabenerledigung und kürzere Ausgaben. Dazu kommen Optimierungen für DeepSeek Harness, Tencent CodeBuddy und WorkBuddy. Wenn Du Harness nutzt, solltest Du laut Release Notes auf 0.2.1-rc.1 oder neuer aktualisieren.
Für Entwickler ist die unmittelbare Änderung einfach: Hinter dem gehosteten Alias deepseek-flash steckt jetzt die neue Version. Du kannst denselben API-Modellnamen weiterverwenden. Halte bei Vergleichen das Datum und die bereitgestellte Modellversion fest. Ein Alias kann auf ein anderes Modell zeigen, obwohl Deine Konfiguration gleich bleibt.
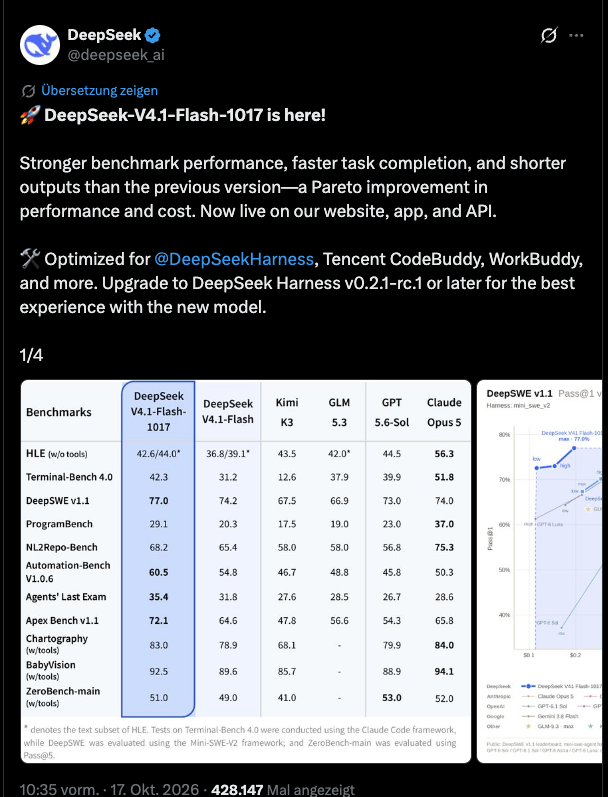
DeepSeeks Ankündigung mit Benchmark-Tabelle. Alle für das Update relevanten Werte stehen vollständig in der Tabelle unten. Das Kostendiagramm rechts ist im Screenshot abgeschnitten.
Benchmarks: die größten Fortschritte gegenüber V4.1 Flash
Das sind DeepSeeks veröffentlichte Vorher-nachher-Werte aus der Ankündigung oben und der Model Card für 1017. Die Differenz in Punkten habe ich durch Subtraktion berechnet.
| Benchmark | Bisheriges V4.1 Flash | Flash 1017 | Differenz |
|---|---|---|---|
| HLE, ohne Tools | 36.8 | 42.6 | +5.8 |
| HLE, reine Textteilmenge, ohne Tools | 39.1 | 44.0 | +4.9 |
| Terminal-Bench 4.0 | 31.2 | 42.3 | +11.1 |
| DeepSWE v1.1 | 74.2 | 77.0 | +2.8 |
| ProgramBench | 20.3 | 29.1 | +8.8 |
| NL2Repo-Bench | 65.4 | 68.2 | +2.8 |
| Automation-Bench v1.0.6 | 54.8 | 60.5 | +5.7 |
| Agents' Last Exam | 31.8 | 35.4 | +3.6 |
| Apex Bench v1.1 | 64.6 | 72.1 | +7.5 |
| Chartography, mit Tools | 78.9 | 83.0 | +4.1 |
| BabyVision, mit Tools | 89.6 | 92.5 | +2.9 |
| ZeroBench-main, mit Tools, Pass@5 | 49.0 | 51.0 | +2.0 |
Besonders auffällig sind +11.1 Punkte bei Terminal-Bench und +8.8 Punkte bei ProgramBench. Das macht die Veröffentlichung für Aufgaben interessant, bei denen ein Agent über mehrere Schritte hinweg ein Programmierproblem lösen muss.
Die Fußnoten sind wichtig. Terminal-Bench 4.0 wurde mit Claude Code als Harness getestet, DeepSWE mit Mini-SWE-V2. ZeroBench-main verwendet Pass@5, erlaubt also mehrere Versuche. Die 44.0 bei HLE gehören zur reinen Textteilmenge; der separat ausgewiesene Wert ohne Tools liegt bei 42.6. Diese Bedingungen stehen im Changelog.
Die vorherige Model Card beschreibt für die ursprüngliche Terminal-Evaluation einen anderen Harness. Die neue Ankündigung erklärt nicht, ob der Vergleichswert erneut gemessen wurde. Lies die Tabelle deshalb als von DeepSeek veröffentlichten Vergleich, dessen Ergebnisse auch vom jeweiligen Evaluationsaufbau beeinflusst sein können.
Wie schneidet das Modell gegenüber GPT und Claude ab?
In der Tabelle zur Veröffentlichung liegt Flash 1017 bei DeepSWE, Automation-Bench, Agents' Last Exam und Apex Bench vor den anderen aufgeführten Modellen. Das sind gute Ergebnisse für Agentenaufgaben.
Dieselbe Tabelle sieht Claude Opus 5 bei HLE ohne Tools vorn, mit 56.3 gegenüber 42.6, und bei Terminal-Bench 4.0, mit 51.8 gegenüber 42.3. GPT-5.6 Sol erreicht den höchsten aufgeführten ZeroBench-main-Wert: 53.0 gegenüber DeepSeeks 51.0.
Diese Vergleiche gelten für die konkreten Modellversionen und Evaluationen in der Ankündigung. Für mich gehört Flash 1017 damit in eine Agenten-Evaluation. Welches Modell passt, hängt von der Aufgabe ab.
Warum kürzere Ausgaben wichtiger sein könnten als ein weiterer Spitzenwert
Ein Coding-Agent liest vielleicht Dateien, schlägt eine Änderung vor, führt Tests aus und überarbeitet seinen Patch. Jeder zusätzliche Versuch kann mehr Modellnutzung, Tool-Laufzeit und Prüfaufwand verursachen. Bei einer Evaluation interessiert mich deshalb der gesamte Zeit- und Kostenaufwand bis zu einem akzeptablen Ergebnis.
DeepSeek beschreibt das Update als Pareto-Verbesserung bei Leistung und Kosten: bessere Ergebnisse bei geringeren Aufgabenkosten in den eigenen Evaluationen. Die Ankündigung nennt außerdem kürzere Aufgabenlaufzeiten. Eine allgemeingültige prozentuale Ersparnis, die ich auf jedes Projekt übertragen könnte, nennt sie nicht.
Die praktische Frage ist, ob das Modell dieselben Abnahmekriterien mit weniger abgerechneten Tokens und in kürzerer Zeit erfüllt. Eine kürzere Antwort hilft, wenn sie die Aufgabe verständlich abschließt. Sie bringt deutlich weniger, wenn ich erst dreimal nachfragen muss, um fehlende Details zu bekommen.
Ich würde erfolgreiche Abschlüsse, den gesamten Token-Verbrauch, Tool-Aufrufe und Prüfzeit gemeinsam messen. So wird aus einer Effizienzbehauptung eine brauchbare Grundlage für die Modellwahl.
API-Preise: unverändert, mit Haupt- und Nebenzeiten
DeepSeeks USD-Preise, geprüft am 17. Oktober 2026, pro Million Tokens:
| Tokenart | Nebenzeit | Hauptzeit |
|---|---|---|
| Eingabe, Cache-Treffer | $0.003 | $0.006 |
| Eingabe, kein Cache-Treffer | $0.15 | $0.30 |
| Ausgabe | $0.60 | $1.20 |
Hauptzeiten: 01:00–04:00 und 06:00–10:00 UTC, Montag–Freitag, ausgenommen chinesische gesetzliche Feiertage. Alle anderen Zeiten sind Nebenzeiten.
Beispiel: 100.000 Eingabe-Tokens ohne Cache-Treffer + 10.000 Ausgabe-Tokens = $0.021 zur Nebenzeit oder $0.042 zur Hauptzeit. Zusätzliche Anfragen und Tool-Gebühren sind nicht eingerechnet.
Open Source: MIT-Code, offene Gewichte und eigenes Hosting
Die Model Card für 1017 stellt das Repository und die Modellgewichte ausdrücklich unter die MIT-Lizenz. Die Lizenzdatei erlaubt Nutzung, Änderung und Weitergabe, auch kommerziell, sofern die vorgeschriebenen Hinweise erhalten bleiben.
Diese Freiheit ist ein wichtiger Grund, warum mich die Veröffentlichung interessiert. Entwickler können die bereitgestellte Implementierung einsehen, die Modellgewichte unabhängig evaluieren und ihre eigene Infrastruktur wählen. Mehr dazu habe ich in warum mir Open Source wichtig ist geschrieben.
Präzise gesagt ist es ein Open-Weight-Modell mit MIT-lizenziertem Code. Aus der Lizenz und dem Download der Gewichte allein folgt nicht, dass auch die vollständigen Trainingsdaten und die gesamte Trainingspipeline veröffentlicht wurden.
Auch das eigene Hosting will geplant sein. Das offizielle Datei-Repository umfasst laut Anzeige rund 510 GB. Es enthält Safetensors-Gewichte, Konfiguration sowie Code für Encoding und Inferenz. Diese Größe beschreibt den Speicherplatz des Repositorys. Wie viel Arbeitsspeicher und welche Hardware der Betrieb benötigt, hängt von Implementierung und Arbeitslast ab. Lies die mitgelieferten Inferenzanleitungen, bevor Du Dich für ein Deployment entscheidest.
So probierst Du Flash 1017 über die API aus
Für einen ersten Check würde ich eine kurze Textanfrage verwenden. Wenn Dein DeepSeek-API-Schlüssel bereits in DEEPSEEK_API_KEY gespeichert ist, kannst Du diese angepasste Version des offiziellen API-Beispiels nutzen:
curl --fail-with-body https://api.deepseek.com/chat/completions \
  -H "Authorization: Bearer ${DEEPSEEK_API_KEY}" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-flash",
    "messages": [
      {
        "role": "user",
        "content": "Erkläre einen häufigen React-Hydration-Fehler in drei Sätzen."
      }
    ],
    "thinking": {"type": "disabled"},
    "max_tokens": 256,
    "stream": false
  }'
Das ist ein kleiner API-Funktionstest mit deaktiviertem Thinking. Für Denkaufgaben beschreibt die Thinking-Mode-Dokumentation, wie Du Thinking aktivierst und den Aufwand mit low, high oder max festlegst. Plane dafür ein zur Aufgabe passendes Ausgabebudget ein. Ich habe dieses Beispiel mit der Dokumentation abgeglichen, aber für diesen Artikel keine kostenpflichtige API-Anfrage ausgeführt.
Wenn Du DeepSeek Harness verwendest, folge vor der Evaluation der Empfehlung, 0.2.1-rc.1 oder neuer einzusetzen.
Was ich als Nächstes testen würde
Meine erste Evaluation würde drei kleine, repräsentative Aufgaben umfassen:
- Ein reproduzierbarer Bug: Dem Agenten einen fehlschlagenden Test geben und prüfen, ob er nach der Korrektur erfolgreich durchläuft, ohne abgeschwächt zu werden.
- Ein klar begrenztes Refactoring: Unverändertes Verhalten verlangen und Umfang sowie Verständlichkeit des Patches prüfen.
- Eine UI-Korrektur anhand eines Screenshots: Das gerenderte Ergebnis mit der Vorlage vergleichen und kontrollieren, was der Agent tatsächlich geändert hat.
Ich würde für alle Modelle denselben Repository-Stand, Harness, dieselben Berechtigungen und Abnahmekriterien verwenden. Danach würde ich die vollständigen Kosten und die verstrichene Zeit jedes Durchlaufs festhalten. Fehlgeschlagene Versuche gehören ebenfalls in diese Messung.
Für mich macht die Kombination aus besseren veröffentlichten Agentenergebnissen, unveränderten Token-Preisen und MIT-lizenzierten Modellgewichten Flash 1017 zu einem interessanten Kandidaten für eine Evaluation. Als Nächstes möchte ich prüfen, ob die kürzeren Durchläufe auch Patches liefern, die ich mit weniger Prüfaufwand akzeptieren kann. Das wäre ein nützlicher Fortschritt im Entwicklungsalltag.
Mein Beitrag auf X
Hier findest Du auch meinen Beitrag auf X:
Lade den Originalbeitrag von X. Dein Browser verbindet sich dabei mit X und dessen Inhaltsanbietern.
Quellen am 17. Oktober 2026 geprüft. Der Screenshot der Ankündigung ist wie bereitgestellt abgebildet. Benchmark-Werte und Laufzeitangaben stammen vom Anbieter; die Punktdifferenzen und das Preisbeispiel sind aus den zitierten Zahlen berechnet.