Ein Modell-Update interessiert mich, wenn es hilft, echte Arbeit fertigzustellen. Nicht, wenn es einen beeindruckenderen Screenshot einer Rangliste produziert.
Anthropic hat Claude Opus 5.5 am 22. September 2026 veröffentlicht. Im Mittelpunkt stehen besseres Coding, klarere Kommunikation und niedrigere Betriebskosten. Interessant ist für mich, was diese Kombination beim Bauen von Websites, bei der Wartung von Anwendungen und bei Code-Reviews verändern könnte.
Das ist eine Analyse veröffentlichter Quellen, kein eigener Praxistest. Preise und Dashboard-Werte wurden am 24. September 2026 geprüft. Meine Evaluierungsideen weiter unten sind Vorschläge, keine Ergebnisse aus Tests von Opus 5.5 in meinen Projekten.
Was ändert sich für Entwickler?
Die offizielle Modellübersicht nennt ein Kontextfenster von einer Million Tokens, Text und Bilder als Eingabe sowie Text als Ausgabe. Die Kennung für die Claude API lautet claude-opus-5-5. Adaptives Denken ist immer aktiv; die voreingestellte Effort-Stufe ist medium.
Mich interessiert weniger, dieses Kontextfenster zu füllen, als eine Aufgabe sauber zu Ende zu bringen: einen Fehler verstehen, die passenden Dateien finden, eine gezielte Änderung vornehmen und prüfen, ob das bisherige Verhalten weiterhin funktioniert.
Für ein kleines Projekt könnte ein Modell, das weniger Betreuung braucht, wertvoller sein als eines mit längeren Antworten. Bevor ich diesen Schluss ziehe, möchte ich aber Ergebnisse aus der tatsächlichen Anwendung sehen.
Was die unabhängigen Benchmarks zeigen
Das Release-Dashboard von Artificial Analysis vergleicht fünf Effort-Konfigurationen mit aktiviertem Standard-Fallback. Das sind Einstellungen derselben Veröffentlichung, nicht fünf eigenständige Modellfamilien.
Die beiden Originaldiagramme in diesem Artikel werden vom Herausgeber bereitgestellt und stammen aus der begleitenden Launch-Analyse von Artificial Analysis. Sie sind weder nachgezeichnete Grafiken noch Live-Einbettungen des interaktiven Dashboards. Öffne die Bilder in voller Größe, um die Beschriftungen zu lesen; aktuelle Filter und Messwerte findest du im Release-Dashboard.
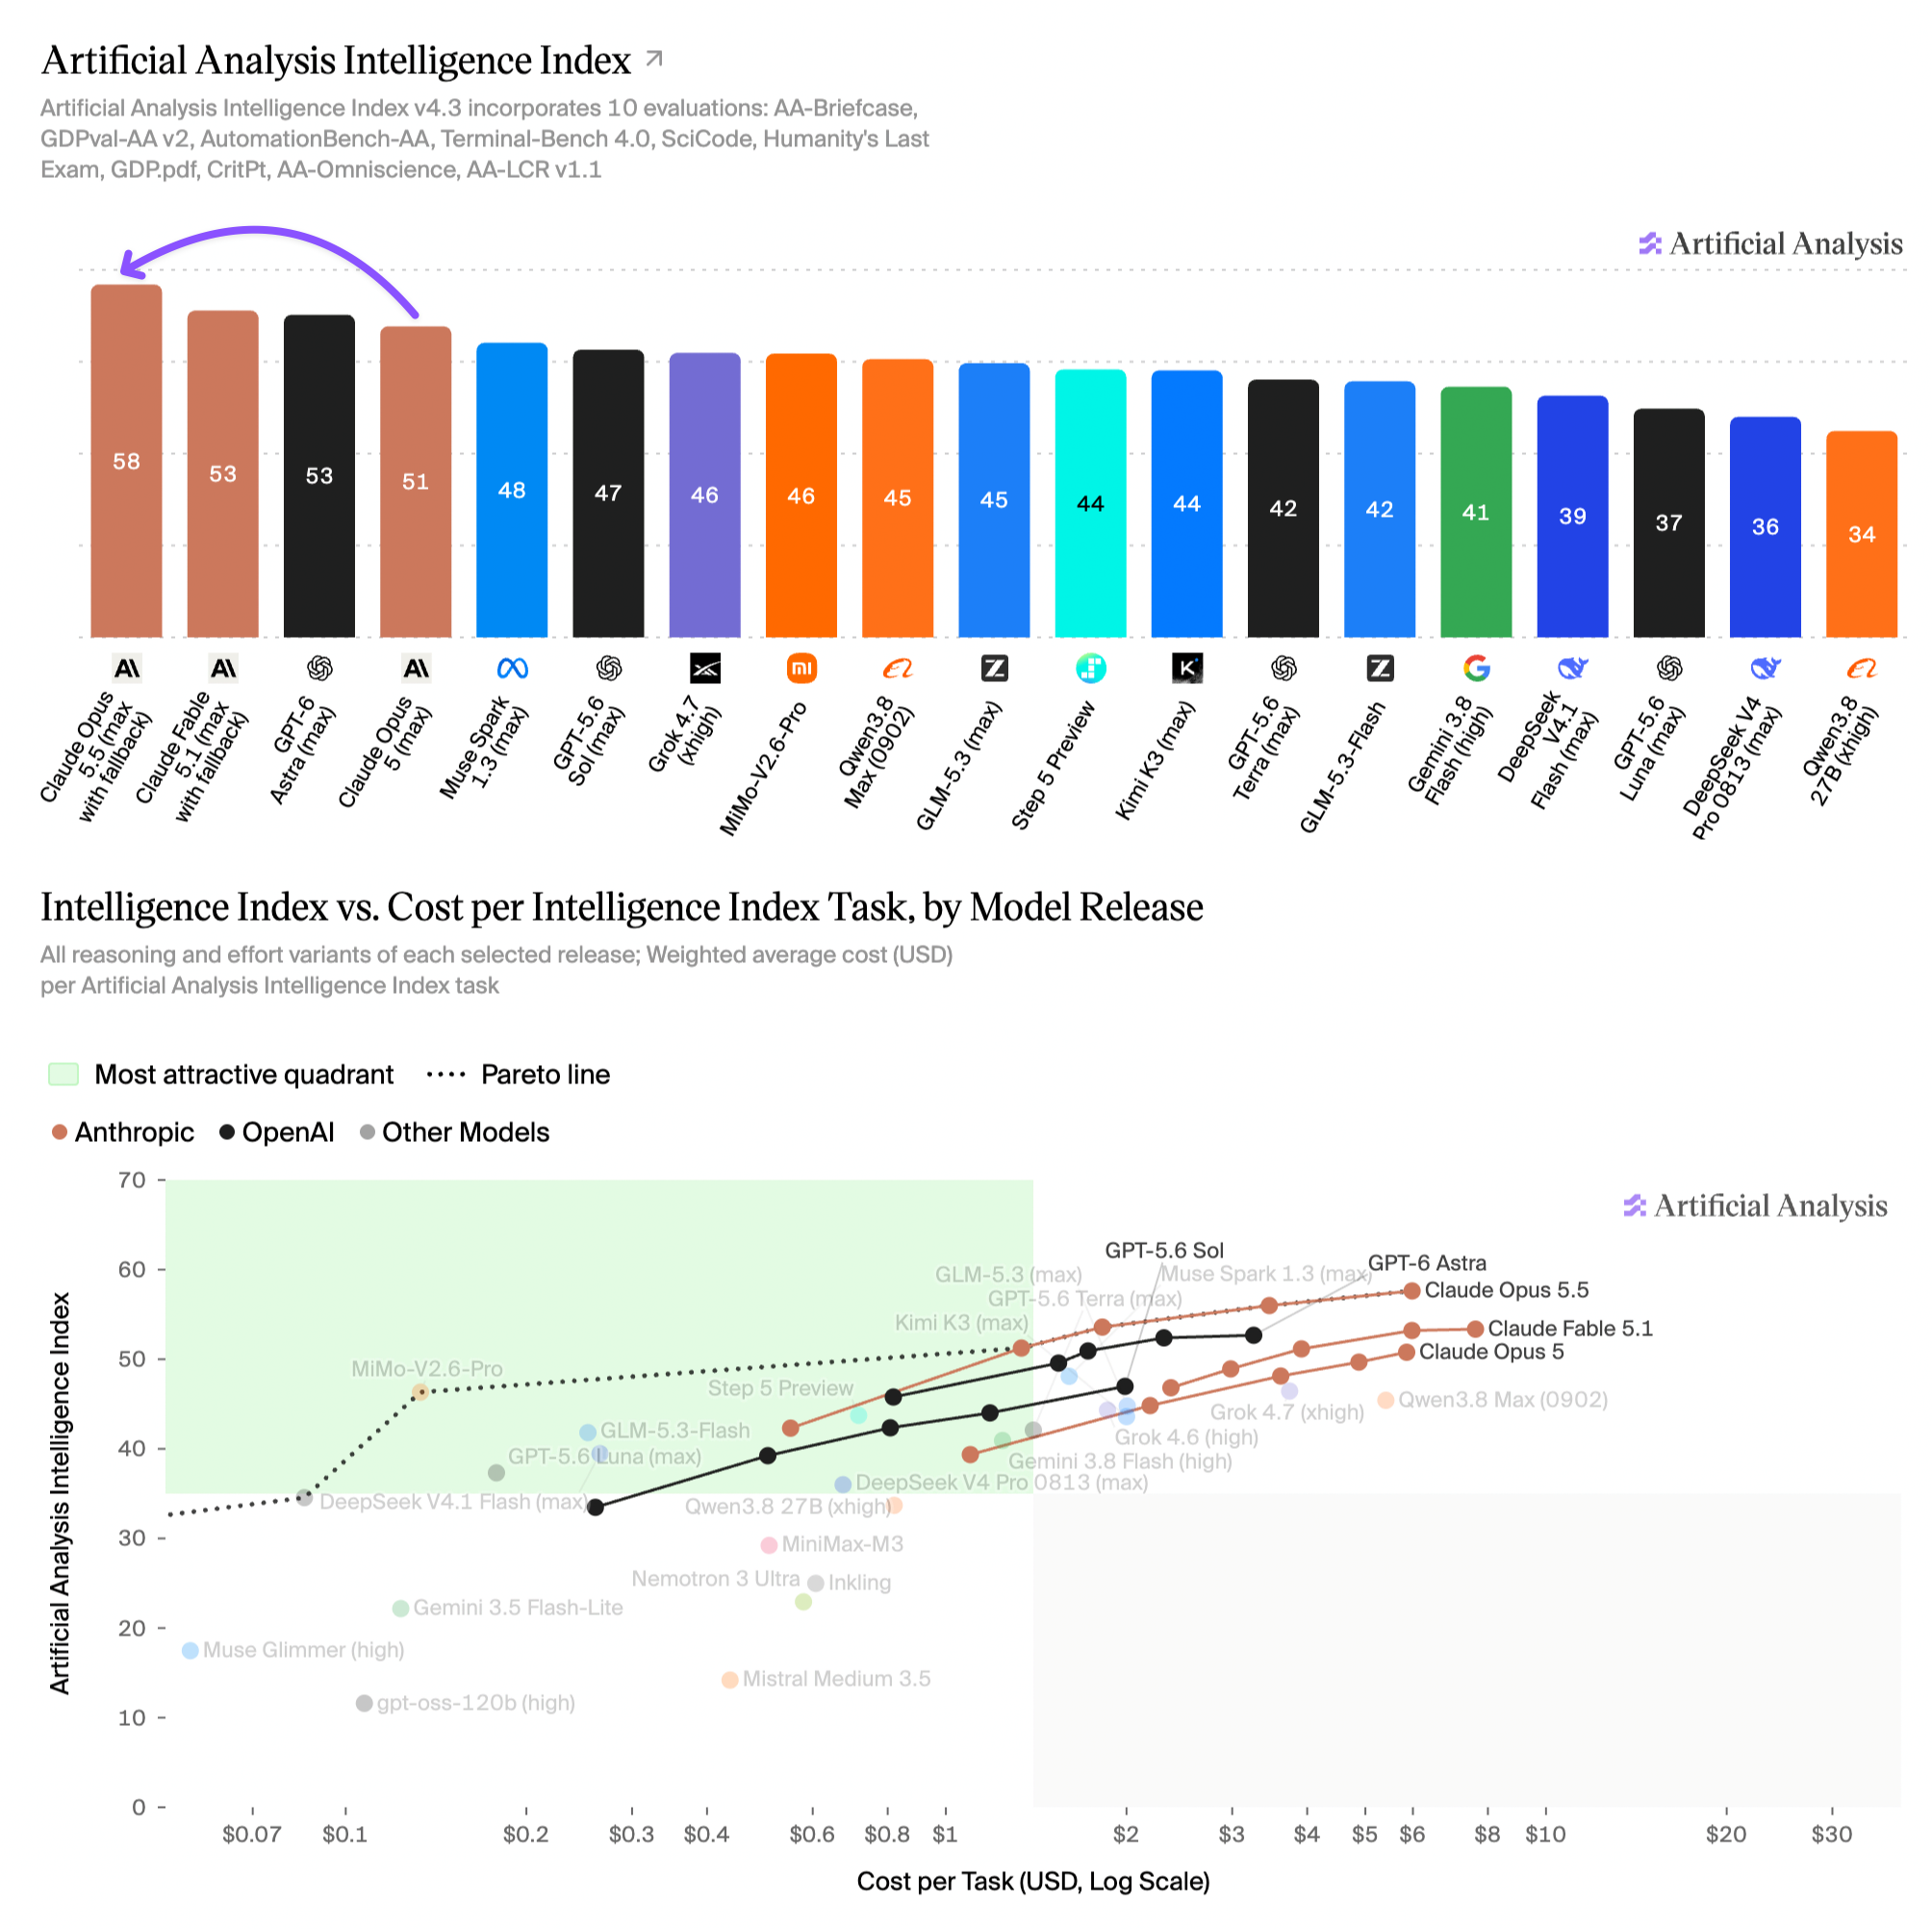
Hier der Dashboard-Stand als Text. Die Kosten gelten in US-Dollar pro Aufgabe des Intelligence Index, nicht pro Million Tokens.
| Effort mit Standard-Fallback | Intelligence Index | Kosten pro Aufgabe (USD) |
|---|---|---|
| low | 42 | $0,55 |
| medium | 51 | $1,34 |
| high | 54 | $1,82 |
| xhigh | 56 | $3,46 |
| max | 58 | $5,98 |
Quelle: Artificial Analysis Release-Dashboard, 24. September 2026. Das sind gewichtete Kosten dieses Benchmarks, kein Kostenvoranschlag für deine Anwendung.
Meine Einordnung: Ich würde max nicht nur deshalb zum Standard machen, weil es diese Tabelle anführt. Ich würde eine Evaluierung mit medium beginnen und prüfen, ob zusätzliche Denkarbeit das Ergebnis ausreichend verbessert. Ein schwieriges Architekturproblem und eine einfache Textänderung brauchen nicht dieselben Bewertungskriterien.
Das nützlichere Diagramm: Qualität im Verhältnis zu Kosten
Eine Rangliste beantwortet eine Frage: Welche getestete Konfiguration hat höher abgeschnitten? Ein Vergleich von Qualität und Kosten fragt zusätzlich: Was bezahlen wir für die Verbesserung?
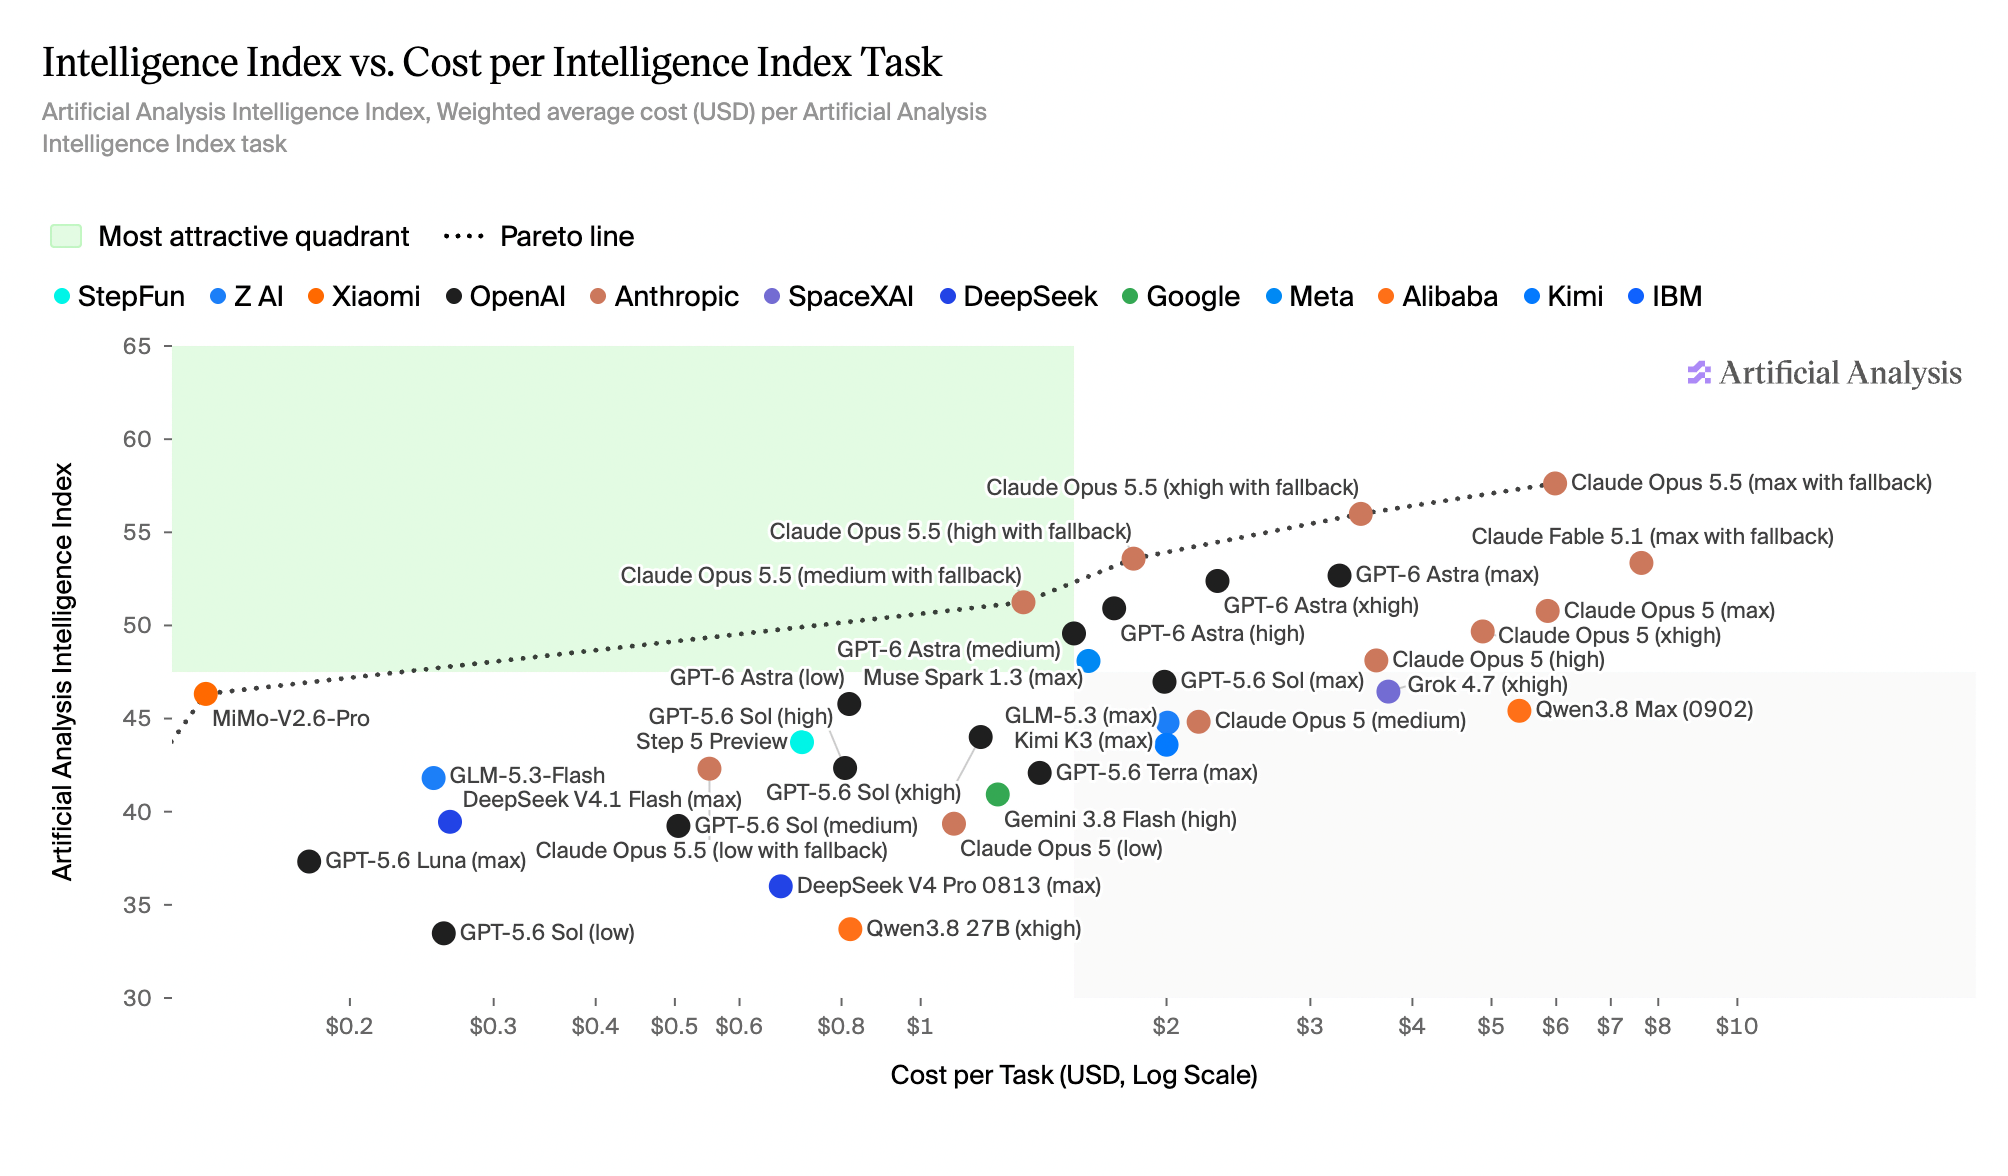
Für meine Arbeit würde ich eine dritte Dimension ergänzen: die Zeit, die ich zum Prüfen und Korrigieren brauche. Eine billige Antwort, die ich neu schreiben muss, ist nicht unbedingt eine günstige Lösung. Umgekehrt lohnt sich mehr bezahlte Denkarbeit nicht automatisch, wenn das abgenommene Ergebnis dadurch nicht besser wird.
Mein praktisches Ziel wäre deshalb: Kosten pro abgenommener Änderung, nicht Kosten pro Antwort. Fehlgeschlagene Versuche und Review-Zeit würde ich mitzählen, nicht nur den Lauf, der am Ende funktioniert.
Günstigere Tokens garantieren keine günstigeren Aufgaben
Das sind die Standardpreise der Claude API laut Anthropics Preisdokumentation, in US-Dollar pro Million Tokens:
| Token-Kategorie | Opus 5 | Opus 5.5 |
|---|---|---|
| Eingabe ohne Cache | $5,00 | $4,00 |
| Ausgabe | $25,00 | $20,00 |
| Cache-Lesezugriffe | $0,50 | $0,20 |
Die normalen Eingabe- und Ausgaberaten sinken um 20 Prozent, Cache-Lesezugriffe um 60 Prozent. Das ist keine pauschale Preissenkung von 40 Prozent für jeden Token.
Anthropics Angabe von 40 Prozent niedrigeren Betriebskosten bezieht sich auf eigene Tests typischer Aufgaben mit Standardeinstellungen. Daraus folgt keine garantierte Ersparnis für jede Aufgabe oder Effort-Stufe.
Dagegen berichtet Artificial Analysis von ungefähr 119.000 Ausgabe-Tokens pro Aufgabe bei max effort, gegenüber rund 73.000 bei Opus 5 mit max. Trotz günstigerer Token-Preise lagen die gemessenen Kosten pro Aufgabe ungefähr gleichauf.
Diese Ergebnisse betreffen unterschiedliche Konfigurationen. Für mich bedeutet das nicht, einen der Vergleiche zu ignorieren. Es bedeutet, dass die Aufgabe, die Effort-Stufe und der gesamte Verbrauch neben jede Aussage zur Ersparnis gehören.
Was diese Diagramme nicht beantworten
Die Methodik des Intelligence Index beschreibt eine gewichtete Sammlung von Bewertungen. Version 4.3.2 kombiniert zehn Tests und konzentriert sich überwiegend auf englischsprachige, textbasierte Arbeit. Ein Indexwert ist weder eine universelle Prozentangabe richtig gelöster Aufgaben noch eine direkte Bewertung deutscher Texte.
Auch der Fallback-Zusatz ist wichtig. Anthropics Veröffentlichung erklärt, dass Schutzmechanismen bestimmte Aufgaben an andere Modelle weiterleiten können. Ein Ergebnis mit aktivem Fallback würde ich deshalb nicht als uneingeschränkte Messung eines einzelnen Modells darstellen.
Das macht den Benchmark nicht nutzlos. Es macht ihn zu einer Vorauswahl, nicht zum Abnahmetest meiner Software. Ich möchte weiterhin sehen, dass das Modell Unsicherheit erklärt, unbeteiligte Dateien in Ruhe lässt und offen sagt, wenn es eine Änderung nicht überprüfen konnte.
Eine API-Migration ist mehr als ein neuer Modellname
Lies vor einer Umstellung den offiziellen Migrationsleitfaden. Deaktiviertes Denken und erzwungene Tool-Auswahl werden nicht unterstützt. Thinking-Blöcke müssen in Tool-Konversationen wie dokumentiert erhalten bleiben. Reasoning zählt zum Ausgabeverbrauch und zum max_tokens-Budget; die sichtbare Antwortlänge beschreibt den Verbrauch also nicht vollständig.
Ich würde zuerst die bestehende Tool-Schleife testen und erst danach Zugriffsrechte erweitern. Mein Ausgangspunkt wäre ein Arbeitsbranch mit prüfbaren Änderungen, ausdrücklichen Berechtigungen und ohne automatisches Produktions-Deployment. Das sind technische Entscheidungen, keine Versprechen eines Modell-Scores.
Wie ich über einen Wechsel entscheiden würde
Ich würde vorab eine kleine Auswahl echter Aufgaben festlegen: einen reproduzierbaren Fehler, ein Refactoring mit unverändertem Verhalten und eine Funktion mit schriftlichen Abnahmekriterien.
Jede Konfiguration bekäme denselben Ausgangscommit, dieselben Anweisungen, Tools und Grenzen. Ich würde mehrere Versuche durchführen, erfolglose Läufe dokumentieren und die Änderungen mit denselben Tests vergleichen. Im Review wäre entscheidend, ob das Ergebnis stimmt, ob die Änderungen im vereinbarten Umfang bleiben und wie oft ich eingreifen musste.
Das nützlichste Ergebnis wäre keine spektakuläre Demo. Es wäre eine wiederholbare Verbesserung, die ich erklären kann: weniger Korrekturen, ein saubererer Patch oder niedrigere Gesamtkosten für dasselbe abgenommene Ergebnis.
Opus 5.5 gehört auf diese Evaluierungsliste. Ob es zum Standard wird, sollte die Arbeit entscheiden, nicht die Schlagzeile zum Launch.