REA gibt deinem Coding-Agenten Werkzeuge, um bestehende Software zu untersuchen, ihren Abläufen auf den Grund zu gehen und dir beim Entwickeln einer eigenen Version einer Funktion zu helfen. Das finde ich ziemlich wild.
Du kennst die Situation: Eine andere App macht etwas genau richtig. Die Suche reagiert sofort. Beim Kopieren eines komplizierten Dokuments bleibt irgendwie die ganze Formatierung erhalten. Und die Bewegung in einem alten Spiel fühlt sich immer noch besser an als in deinem Prototyp von letzter Woche.
Meistens wird daraus ein vages Ticket: „Bei uns soll das ungefähr so funktionieren.“
REA, kurz für Reverse Engineer Anything, macht eine nützlichere Frage praktikabel: Was passiert zwischen Eingabe und Ergebnis, und welche Teile müsste ich selbst implementieren?
Es verbindet Coding-Agenten wie Claude Code und Codex mit Werkzeugen zur Softwareanalyse. Das Repository zeigte rund 96.000 Sterne, als ich am 11. Oktober 2026 nachgeschaut habe. Auf GitHubs täglicher Trending-Seite stand es an erster Stelle. Das sind Momentaufnahmen. Interessant ist, was sich mit diesem Ablauf anfangen lässt.
Dieser Guide behandelt die Installation, veröffentlichte REA-Fallstudien, ArtCrafts Projekte rund um Adobe-Software und praktische Einstiegspunkte. Ich habe die Dokumentation recherchiert und die verlinkten Quelldateien geprüft. Die vorgestellten App- und Spiele-Nachbauten habe ich nicht selbst ausgeführt.
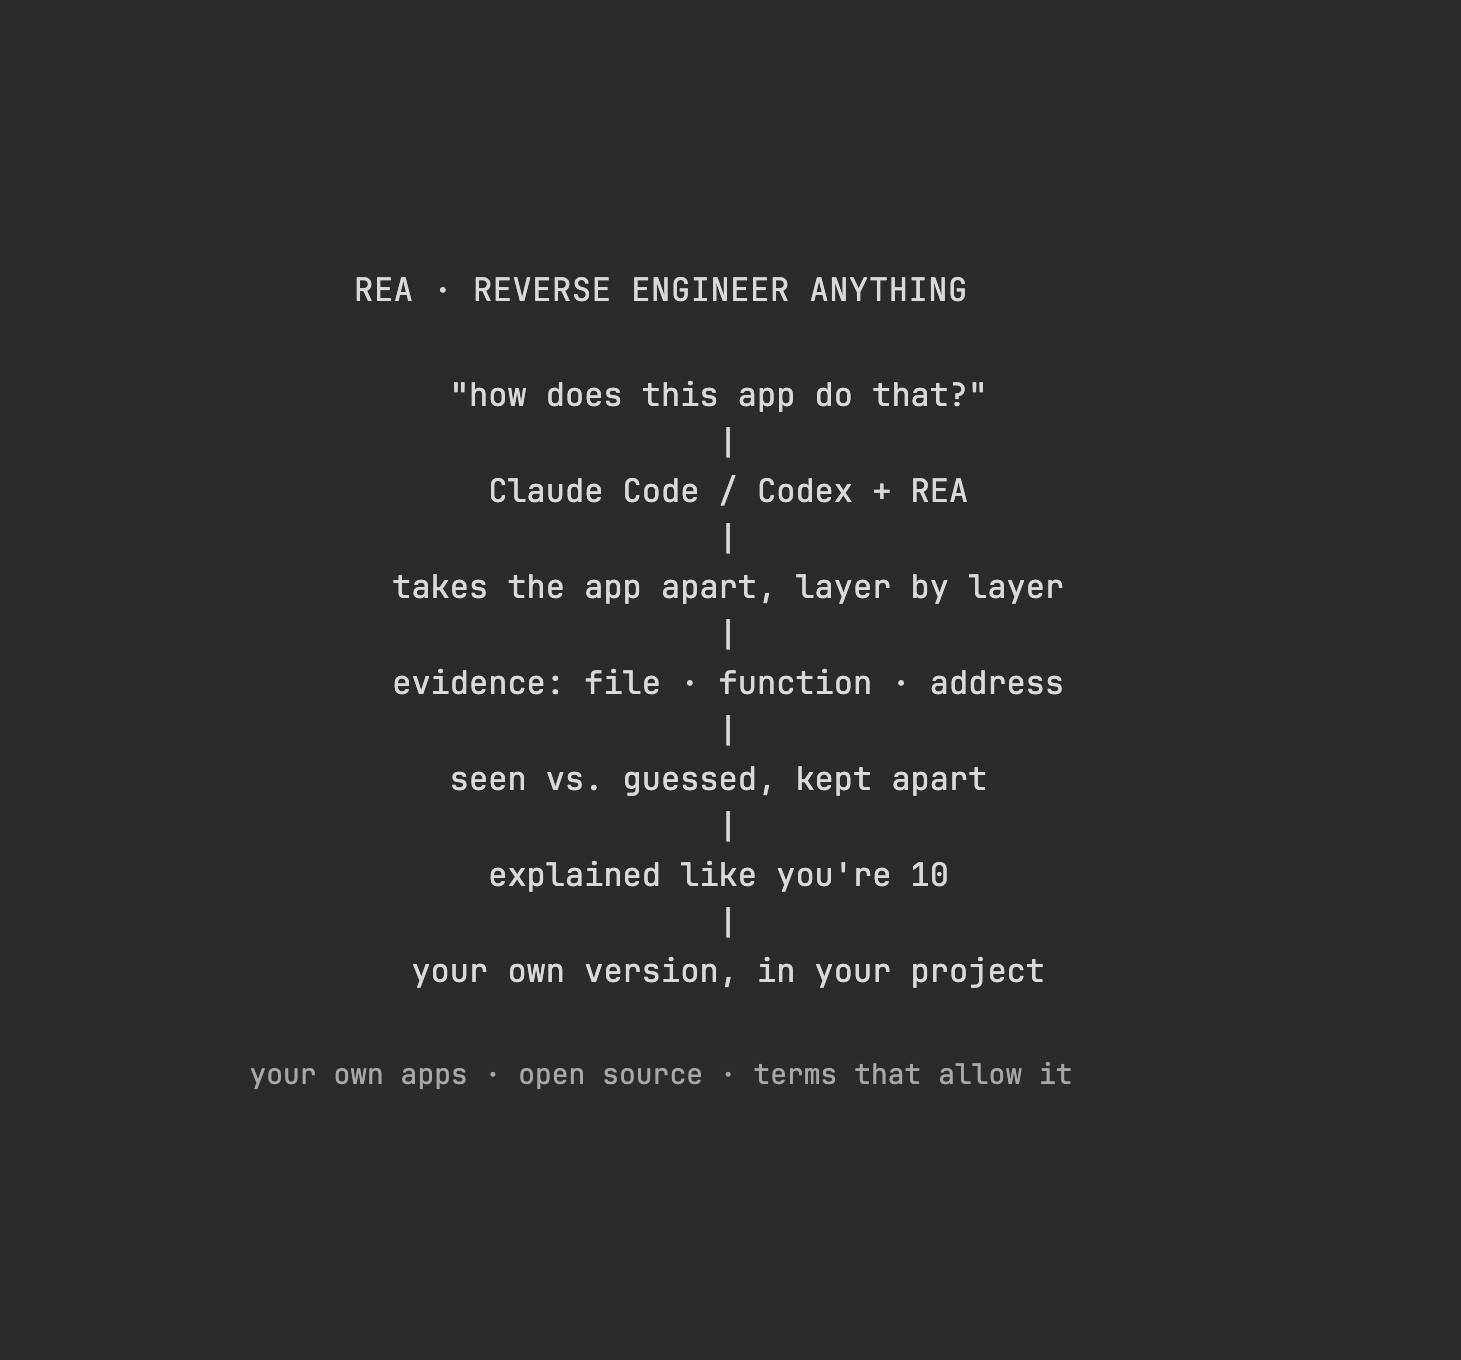
Was REA einem Coding-Agenten hinzufügt
Eine fertige Anwendung enthält das Ergebnis vieler technischer Entscheidungen. Manche davon bleiben in JavaScript-Bundles, Dateiformaten oder Netzwerkaktivität sichtbar. Andere stecken im kompilierten Maschinencode.
Der Vergleich mit einem Kuchen passt erstaunlich gut: Der Quellcode ist das Rezept, das Kompilieren der Backvorgang und die ausführbare Datei der fertige Kuchen. Den Kuchen zu untersuchen, kann viel verraten. Die ursprünglichen Notizen, den Namen jeder Zutat oder die genaue Reihenfolge beim Aufschreiben des Rezepts bekommt man dadurch aber nicht zuverlässig zurück.
REA liefert dafür zwei nützliche Bausteine:
- Werkzeuge, erreichbar über die Kommandozeile und MCP. Über diese Verbindung ruft ein Agent externe Fähigkeiten auf.
- Anleitungen für die Untersuchung, die den Agenten dabei unterstützen, das Ziel zu bestimmen, relevante Belege zu verfolgen und offene Fragen festzuhalten.
Die CLI-Dokumentation erklärt, wie sich Analyseergebnisse und ihre Belege aufbewahren lassen. Die Untersuchungs-Prompts helfen bei Anschlussfragen und der Überprüfung.
Diese Aufteilung ist wichtig. Das Modell entscheidet, was es untersucht, und erklärt seine Interpretation. Die Analysewerkzeuge liefern etwas Konkretes, das sich prüfen lässt. Auch eine überzeugende Erklärung muss sich am untersuchten Programm überprüfen lassen.
Für mich ist das nützliche Ergebnis eine kurze technische Spezifikation: Eingaben, Ausgaben, Umwandlungen, Abhängigkeiten und Randfälle. Damit kann ich entscheiden, wie die Funktion in meinem eigenen Produkt arbeiten soll.
Welche Software kann REA untersuchen?
Bestimme zuerst das Ziel. Eine Electron-App, ein Android-Paket und ein natives Windows-Programm brauchen unterschiedliche Werkzeuge.
| Ziel | Nützliche Belege | Was der Ablauf braucht |
|---|---|---|
| JavaScript oder Electron | Module, Imports, Quellpositionen und Kommunikation zwischen Prozessen | Ein bereitgestelltes Anwendungsverzeichnis oder ASAR; die statische Untersuchung braucht keinen nativen Decompiler |
| Eine Website | Seitenstruktur, clientseitige Skripte und beobachtete Browser- und Netzwerkaktivität | Einen unterstützten Browser aus der Chrome-Familie und das ausgewählte Ziel |
| Native Anwendung | Assemblercode, Pseudocode, Konstanten, Aufrufer und Referenzen | Eine kompatible Einrichtung von Hopper, Ghidra oder IDA |
| .NET-Assembly | Metadaten und Anweisungen der Zwischensprache | REAs statischen Ablauf für Managed Code |
| Android-APK | Manifest, Klassen, Methoden und Referenzen | Das dokumentierte Headless-JADX-Setup und ein vollständiges JDK |
Die Details stehen im JavaScript-Guide, Browser-Guide, Guide zur nativen Analyse, Managed-Code-Guide und Android-Guide. Prüfe, welche Funktionen und Betriebssysteme die installierte Version tatsächlich unterstützt.
Bei einer Website gibt es noch eine wichtige Unterscheidung: Das Frontend und die API-Antworten zu beobachten, legt die unsichtbare Implementierung auf dem Server nicht offen. Vielleicht lässt sich feststellen, dass eine Anfrage sortierte Suchergebnisse zurückgibt. Um zu erklären, wie diese Reihenfolge berechnet wird, braucht es weitere Belege.
REA in Claude Code oder Codex einrichten
1. Node.js prüfen
Der aktuelle Setup-Guide nennt Node.js ab 22.19 innerhalb der 22.x-Reihe, ab 24.11 innerhalb von 24.x oder ab 26, jeweils zusammen mit npm. Das ist genauer als „irgendeine aktuelle Node-Version“.
node --version
npm --version
2. Setup starten
Der kurze Installationsbefehl des Projekts lautet:
npx rea-agents setup
Ich würde ausdrücklich das neueste veröffentlichte Paket anfordern:
npx rea-agents@latest setup
Wähle Claude Code, Codex oder beide aus. Prüfe die vorgeschlagenen Konfigurationsänderungen und übernimm die passenden. Danach den betroffenen Agenten neu starten.
Laut Installationsdokumentation registriert das Setup den MCP-Server und installiert passende Anleitungen. Wer nur den Skill installiert, muss die Werkzeugverbindung noch separat einrichten. Außerdem sind die npm-Bestätigung zum Herunterladen des Pakets und die Freigabe der Konfigurationsänderungen in REA zwei verschiedene Abfragen.
3. Mit einem Ziel beginnen, das wenige Abhängigkeiten braucht
Deine eigene kleine JavaScript- oder Electron-Anwendung ist ein guter erster Untersuchungsgegenstand. Der dokumentierte Befehl für die statische Analyse akzeptiert ein Anwendungsverzeichnis oder ASAR, ohne das Zielprogramm auszuführen:
npx -y rea-agents@latest analyze-javascript-application \
  "/absolute/path/to/your-app.asar" --json
Ersetze den Pfad durch deine eigene Datei. Der JavaScript-Ablauf hält Quellpositionen und nicht aufgelöste Beziehungen fest.
Für native Analysen nutzt du die Einrichtungsanleitung für die Analysewerkzeuge. Ghidra und IDA verwenden bestehende Installationen; Hopper kann während des Setups separat vorgeschlagen werden. Ihre Anforderungen und Lizenzen gelten unabhängig von REA.
4. Die Verbindung prüfen, wenn Werkzeuge fehlen
Nach dem Neustart lautet der Diagnosebefehl aus der FAQ für Codex:
npx -y rea-agents@latest doctor --client codex --json
Für Claude Code verwendest du --client claude_code. Auch eine gültige Konfiguration braucht eine funktionierende Verbindung in der aktiven Agentensitzung.
Die Versionshinweise in der Setup-Dokumentation unterscheiden zwischen dem Repository-Stand auf main und dem veröffentlichten npm-Paket. Orientiere dich an den Werkzeugen, die dein verbundener Server tatsächlich bereitstellt. Dieser Ablauf setzt Opus 5.5 nicht voraus; bei REAs Client-Anforderungen geht es um die Unterstützung lokaler MCP-Server.
Beispiel 1: Warum Notion beim Kopieren die Formatierung behält
REAs veröffentlichte Notion-Fallstudie verfolgt einen Zwischenablagevorgang in Notion Desktop 7.6.1 von tab_browser_view/preload.js bis zu main/index.js. Sie folgt dem Kanal notion:clipboard:write bis zur Schreibfunktion von Electrons Zwischenablage-API, einschließlich einer Absenderprüfung. Außerdem untersucht die Studie strukturierte Blockdaten anhand separat zwischengespeicherter Web-Assets.
Das ist ein deutlich nützlicherer Befund als „Notion benutzt wahrscheinlich HTML“.
Grundsätzlich kann ein Kopiervorgang mehrere Darstellungen desselben Inhalts bereitstellen. Ein einfacher Texteditor verwendet den Text. Ein Editor mit Formatierungsfunktionen kann HTML übernehmen. Electrons Zwischenablage-API unterstützt ausdrücklich das gemeinsame Schreiben von Text und HTML.
Stell dir vor, du kopierst eine Aufgabenliste aus deiner eigenen App. Vielleicht möchtest du:
- Lesbaren Text, wenn jemand die Liste in ein Terminal einfügt.
- Formatierten Inhalt, wenn jemand sie in eine E-Mail einfügt.
- Deine eigenen strukturierten Aufgabenobjekte, wenn jemand sie in eine andere Instanz deines Editors einfügt.
Das sind drei Produktanforderungen. Sie führen zu unterschiedlichen Implementierungen und Kompatibilitätstests.
Für eine eigene Version würde ich eine Textdarstellung, eine HTML-Darstellung und bei Bedarf ein versioniertes internes Format definieren. Anschließend würde ich das Einfügen in einigen tatsächlichen Zielanwendungen testen. Bei einer Desktop-App würde ich außerdem prüfen, welcher Prozess auf die Systemzwischenablage zugreifen darf.
Was du in dein Projekt mitnehmen kannst, sind das benötigte Verhalten und die erkannten Bedingungen. Für den internen Aufbau kannst du dich anders entscheiden.
Beispiel 2: Die sofortige Suche in deiner eigenen App untersuchen
Hier ist eine beispielhafte Untersuchung, die ich mit einem älteren Build meiner eigenen Notizen-App ausprobieren würde.
Die Frage ist bewusst klein:
Wie aktualisiert diese App nach der Eingabe von drei Buchstaben die Ergebnisse, und was verhindert, dass eine ältere Suche eine neuere ersetzt?
Ich würde den Agenten bitten, den Eingabehandler, eine mögliche Verzögerung, den Suchaufruf und die Aktualisierung der Ergebnisse zu verfolgen. Anschließend würde ich die wichtige Unsicherheit gezielt prüfen:
| Was ich beobachte | Mögliche Erklärung | Ein Test, der die Erklärungen unterscheidet |
|---|---|---|
| Keine Netzwerkanfrage beim Tippen | Die Suche könnte lokale Daten verwenden | Den Suchaufruf untersuchen und mit deaktivierter Netzwerkverbindung testen |
| Ergebnisse erscheinen nach einer kurzen Pause | Die Eingabe könnte per Debouncing verzögert werden | Das Timing des Handlers bei kontrollierten Eingabefolgen vergleichen |
| Auch schnelles Tippen zeigt nie veraltete Ergebnisse | Anfragen könnten abgebrochen oder Ergebnisse anhand ihrer Reihenfolge verworfen werden | Zwei Suchvorgänge absichtlich in umgekehrter Reihenfolge abschließen lassen |
Das sind Hypothesen, keine Befunde über eine bestimmte kommerzielle Notizen-App. Ein Cache, ein Worker oder ein vorab geladener Datensatz könnte die Erklärung verändern.
Für meine eigene Implementierung könnten ein Eingabehandler, eine Suchfunktion, eine Ergebnisliste und eine Regel zum Verwerfen veralteter Ergebnisse ausreichen. Ein Worker oder ein aufwendigerer Index lohnt sich erst, wenn Messungen dafür sprechen.
Mein Abnahmetest wäre konkret: Suche A starten, Suche B starten, B zuerst abschließen lassen und danach A beenden. Auf dem Bildschirm sollten weiterhin die Ergebnisse von B stehen. Dieser Test sagt mir mehr über die Korrektheit als ein Agent, der die Architektur modern findet.
Beispiel 3: ArtCraft und die Crafting Apps rund um Adobe-Software
Das ArtCraft-App-Verzeichnis zeigt auf faszinierende Weise, wie groß das Interesse am Nachbauen vertrauter kreativer Arbeitsabläufe ist. Es führt aktuell zwölf native Rust-Anwendungen auf.
Dabei gibt es zwei verschiedene Dinge:
- storytold/artcraft ist ein Studio zur KI-gestützten Bild- und Videoerstellung mit 2D-Komposition und 3D-Szenenaufbau.
- Die Crafting Apps sind separate Projekte. Mehrere beschreiben sich ausdrücklich als Clean-Room-Neuimplementierungen von Adobe-Software.
Einige Beispiele aus ihren eigenen Repositories:
| Projekt | Der vertraute Arbeitsablauf, den es nachbildet |
|---|---|
| PhotoCraft | Bildbearbeitung nach Art von Photoshop |
| FilmCraft | Videoschnitt nach Art von Premiere Pro |
| LightCraft | Fotografie-Workflows nach Art von Lightroom |
| PdfCraft | PDF-Arbeit nach Art von Acrobat |
„Clean Room“ ist die Beschreibung der Maintainer für ihren Entwicklungsansatz. Ich habe keinen Primärbeleg dafür gefunden, dass REA diese Projekte gebaut hat. Deshalb behandle ich sie als verwandte Beispiele für Neuimplementierungen.
Dass diese Projekte Open Source sind, ist ein wichtiger Teil meines Interesses. ArtCraft und PhotoCraft bieten ihren Code unter MIT oder Apache-2.0 an, mit separaten Hinweisen zu Material Dritter. Du kannst dir die Implementierung und die Tests hinter einer Funktionsbehauptung selbst ansehen.
PhotoCraft zeigt, was „kompatibel“ bedeuten muss
PhotoCraft beschreibt seine PSD-Implementierung als Arbeit auf Grundlage öffentlicher Spezifikationen und beobachteten Verhaltens. Adobe veröffentlicht die Photoshop File Formats Specification. Damit haben andere Entwickler eine dokumentierte Grundlage, um PSD- und PSB-Dateien zu lesen und zu schreiben.
Eine Datei lesen zu können, ist allerdings erst der Anfang.
Ich habe mir drei unterschiedliche Tests im PhotoCraft-Repository angesehen:
| Test | Die Frage dahinter |
|---|---|
| PSD-Korpus | Kann der Parser eine Testdatei lesen und bytegleich wieder schreiben? |
| Import-/Export-Korpus | Entspricht das gerenderte Importergebnis einer gespeicherten Referenz, und bleibt die Darstellung der App nach Export und erneutem Import erhalten? |
| Rendering-Referenztests | Können die eigenen Engines das erwartete Bild wiederherstellen, nachdem zwischengespeicherte Pixel für Text und Smartobjekte entfernt wurden? |
Gerade die letzte Unterscheidung finde ich gut. Eine gespeicherte Datei kann bereits ein fertiges Bild eines Effekts enthalten. Dieses Bild anzuzeigen, ist einfacher, als den Effekt neu zu berechnen, nachdem jemand seine Eingaben verändert hat.
So würde ich daraus ein kleines eigenes Projekt machen: ein Dokument mit zwei Rasterebenen, einer Maske und einem Mischmodus unterstützen. Den unterstützten Umfang festlegen. Testdateien erstellen, deren Weitergabe erlaubt ist. Prüfen, ob der Parser ihre Informationen erhält, der Renderer die erwarteten Pixel erzeugt und eine geänderte Ebene das Speichern und erneute Öffnen übersteht.
Damit habe ich eine Funktion, die ich beurteilen kann. Eine vertraute Werkzeugleiste allein sagt wenig darüber aus, was passiert, wenn jemand ein Dokument verändert.
PhotoCrafts README bezeichnet die Anwendung weiterhin als frühe Alpha und warnt davor, sie als täglichen professionellen Photoshop-Ersatz zu behandeln. Die Richtung finde ich beeindruckend. Wie alltagstauglich sie ist, muss sich gesondert zeigen.
Beispiel 4: Ja, das machen Leute auch mit Spielen
Ich habe bereits über KI-Modding und Reverse Engineering bei Spielen geschrieben. Dabei ging es auch darum, eine unerwartete Mechanik in eine vertraute Spielwelt zu bringen. REA liefert dazu Beispiele, bei denen sich eine deutlich kleinere technische Aussage untersuchen lässt.
Eine Klangberechnung in DX-Ball
Die offizielle DX-Ball-Fallstudie verfolgt eine Hilfsfunktion für das Stereo-Panning an der Adresse 0x00406400. Die veröffentlichte Rekonstruktion berichtet von 3.205 Vergleichen mit der ursprünglichen x86-Funktion und 63 übereinstimmenden kompilierten Bytes mit einem festgelegten historischen Compiler.
Der Umfang ist eine einzelne Berechnung. Das Beispiel ist stark, weil die Erklärung an Anweisungen, Aufrufer, Konstanten und Prüfungen gebunden ist.
Für ein eigenes Spiel könnte die Gestaltungsfrage schlicht lauten: Wie soll ein Geräusch zwischen dem linken und rechten Lautsprecher wandern, während sich ein Objekt über den Bildschirm bewegt? Die alte Funktion zu rekonstruieren, kann das Verhalten des alten Spiels erklären. Deine eigene Audio-Engine braucht möglicherweise einen anderen Wertebereich oder eine andere Panning-Kurve.
Ein Ring aus Projektilen in TH04
REAs TH04-Fallstudie untersucht bullet_velocity_and_angle_set() in einer DOS-Programmdatei. Sie verfolgt einen gleichmäßig verteilten Ring und die zusätzlich eingerechnete Richtung zum Spieler. Das Original stellt eine volle Umdrehung mit 256 Winkeleinheiten dar.
Um die allgemeine Idee in einem neuen Spiel zu erklären, ist das gewöhnliche Bogenmaß einfacher. Das hier ist mein eigenes vereinfachtes Beispiel, nicht die rekonstruierte TH04-Implementierung:
function makeBulletRing(count, speed, rotation = 0) {
  if (!Number.isInteger(count) || count < 1) {
    throw new RangeError("count must be a positive integer");
  }

  return Array.from({ length: count }, (_, index) => {
    const angle = rotation + (2 * Math.PI * index) / count;
    return {
      vx: Math.cos(angle) * speed,
      vy: Math.sin(angle) * speed,
    };
  });
}

const velocities = makeBulletRing(16, 120);
Jedes Projektil bekommt eine Richtung. Sechzehn Projektile teilen eine volle Umdrehung in sechzehn gleich große Teile. Die Geschwindigkeit bestimmt, wie schnell sie sich bewegen; die Rotation dreht das gesamte Muster.
Bei Bildschirmkoordinaten, deren positive Y-Richtung nach unten zeigt, sollte dieselbe Konvention für die Zielrichtung gelten. Ein auf den Spieler gerichtetes Muster kann Math.atan2(playerY - originY, playerX - originX) als Rotation verwenden.
Das ist ein gut zugänglicher Einstieg. Für das ursprüngliche Spielgefühl müssten außerdem Timing, Ganzzahlrundung, Erzeugungsregeln und Schwierigkeitsanpassungen stimmen. Die Geometrie zu verstehen, löst einen Teil des Problems.
Rekompilierung, Dekompilierung, Emulation und Modding
Ein Video, in dem ein altes Spiel auf einer neuen Plattform läuft, verrät noch nicht, mit welcher Technik das erreicht wurde.
| Begriff | Was er beschreibt |
|---|---|
| Dekompilierung | Eine Quelldarstellung aus einem kompilierten Programm zurückgewinnen, deren Verständnis weitere Analyse braucht |
| Statische Rekompilierung | Kompilierte Anweisungen vor der Ausführung in Code für eine andere Build- oder Laufzeitumgebung übersetzen |
| Emulation | Das Verhalten einer Ausführungsumgebung nachbilden, gegebenenfalls mit mehreren Ausführungstechniken |
| Modding | Das Verhalten oder die Inhalte eines Spiels verändern; die Methode dahinter kann variieren |
N64Recomp dokumentiert die anweisungsweise Übersetzung nach C mit unterstützenden Metadaten und einer Laufzeitumgebung. zeldaret/oot ist ein Projekt zur Quellcode-Rekonstruktion. QEMUs Dokumentation erklärt den Ansatz über die Ausführungsumgebung. Die Begriffe beschreiben unterschiedliche Ziele und Ebenen; reale Projekte können Techniken kombinieren.
Zelda64Recomp ist ein konkretes Beispiel für statische Rekompilierung. Seine Veröffentlichungen enthalten keine Spiel-Assets und setzen das Originalspiel voraus. Die Maintainer lehnen außerdem generative KI in der Entwicklung ausdrücklich ab. Es ist daher ein Beispiel für die Technik, kein KI- oder REA-Showcase.
Zur Einordnung hier die angegebene Sammlung Chun's Ready-to-Go Recomp Games. Ich konnte weder ihre aktuellen Einträge noch die Berechtigungen für einzelne Uploads verifizieren. Der Link zeigt das Interesse rund um das Thema. Er belegt nicht, dass diese Einträge mit REA erstellt wurden oder weitergegeben werden dürfen.
Beispiel 5: Die Regeln in deinem eigenen alten Werkzeug wiederfinden
Der unspektakulärere Anwendungsfall könnte der wertvollste sein.
Stell dir vor, dein Unternehmen hängt noch von einem alten Hilfsprogramm ab, das Lieferantendateien in Rechnungsimporte umwandelt. Der Quellcode ist verschwunden. Es läuft noch, aber niemand kann erklären, warum eine Datei funktioniert und eine andere scheitert.
Eine nützliche Untersuchungsfrage wäre:
Welche Regeln bestimmen in diesem Hilfsprogramm, das uns gehört, ob eine CSV-Zeile akzeptiert wird, und wie werden Datum und Betrag umgewandelt?
Ich würde einige künstliche Eingaben vorbereiten: ein leeres Feld, ein Dezimalkomma, ein Trennzeichen in Anführungszeichen, ein ungültiges Datum und eine doppelte Rechnungs-ID. Wenn die Ausführung freigegeben ist, würde ich Kopien in einer isolierten Testumgebung ausführen und die Ausgaben erfassen. Anschließend könnte der Agent die relevanten Wege durch Parser und Umwandlungslogik verfolgen.
Das Ergebnis sollte Eingabeformat, Umwandlungsregeln, Ablehnungsfälle und ungeklärtes Verhalten beschreiben. Damit lässt sich mit den Menschen, die auf das Werkzeug angewiesen sind, über einen Ersatz sprechen.
Ich würde außerdem fragen, ob jede Eigenheit erhalten bleiben muss. Wenn das Original ungültige Zeilen stillschweigend verwirft, könnte ein identischer Nachbau zwar die Kompatibilität erhalten, aber zugleich ein ernstes betriebliches Problem fortführen. Eine dokumentierte Migrationsentscheidung ist besser, als jede Macke automatisch zu übernehmen.
Der Prompt, den ich verwenden würde
Starte mit einer Funktion und einem kleinen Ziel. Dieser Prompt hält die Untersuchung fokussiert und macht den Übergang zur Implementierung deutlich:
Ich möchte mit REA eine Softwarefunktion verstehen und eine eigene
Implementierung für mein Projekt planen.

1. Frage mich nach der App oder dem Repository, der Version oder dem
   lokalen Pfad, der genauen Funktion und einem kleinen Beispiel für
   das Verhalten, das mir wichtig ist. Lass mich die Grundlage für
   die Untersuchung bestätigen: eigene Software, eine passende
   Open-Source-Lizenz oder eine ausdrückliche Erlaubnis.
   Ist das unklar, pausiere die Analyse des Ziels.

2. Bestimme den Zieltyp und die verfügbaren Fähigkeiten dieser
   REA-Installation. Beginne mit der kleinsten nützlichen statischen
   Analyse. Fehlt ein externes Werkzeug, nenne es, erkläre seinen
   Zweck und verlinke seine offizielle Installationsanleitung.
   Installiere keine Werkzeuge und ändere die Konfiguration meines
   Agenten nicht automatisch.

3. Verfolge die Funktion von der Eingabe bis zur Ausgabe. Nenne für
   jeden wichtigen Befund die Datei und Quellposition oder die
   Funktion und Adresse sowie die Zielversion oder Artefaktidentität.
   Trenne beobachtete Fakten, Schlussfolgerungen und offene Fragen.
   Erfinde keinen rekonstruierten Quellcode.

4. Erkläre das Ergebnis verständlich. Gib mir eine kurze technische
   Spezifikation: Eingaben, Ausgaben, Zustand, Abhängigkeiten und
   Randfälle. Schlage für jede unsichere Aussage die kleinste Prüfung
   vor, die sie widerlegen könnte. Frage nach, bevor du das Ziel
   startest oder Laufzeit- und Netzwerkdaten aufzeichnest.

5. Schlage die kleinsten nötigen Bausteine für meine Implementierung
   vor, mit eigenem Code und Material, das ich verwenden darf.
   Nenne einige Abnahmetests und offene Kompatibilitätsentscheidungen.
   Zeige mir den Plan und warte auf meine Freigabe, bevor du Code
   für das Produkt schreibst.
Es geht darum, eine beantwortbare Frage zu bekommen. „Baue diese komplette professionelle Anwendung nach“ macht es deutlich schwerer einzuschätzen, ob der Agent überhaupt etwas richtig verstanden hat.
Open Source, Datenschutz und die Grenzen, auf die es ankommt
REA selbst steht unter der MIT-Lizenz. Du kannst das Werkzeug unter Beachtung seiner Lizenzhinweise untersuchen und anpassen. Die Lizenz der analysierten Software ändert das nicht. Für genau solche einsehbaren Werkzeuge habe ich in Warum Code frei sein sollte argumentiert.
Auch „lokale Analyse“ braucht eine genaue Bedeutung. REA führt die Analyse lokal aus, aber der Coding-Agent erhält die Ergebnisse. Die Datenrichtlinien seines Modellanbieters gelten weiterhin, wie die REA-FAQ erklärt. Bei einer internen Unternehmensanwendung solltest du prüfen, ob Codeausschnitte, Zeichenketten, Pfade oder aufgezeichnete Daten an diesen Anbieter übermittelt werden dürfen. Modellnutzung und kommerzielle Analysewerkzeuge können außerdem eigene Kosten verursachen.
Kläre bei jedem Projekt die relevanten Rechte und Bedingungen, bevor du sein Material untersuchst oder teilst. „Nur zu Bildungszwecken“ begründet für sich allein keine Lizenz oder Erlaubnis, Software, Spieldaten oder Assets weiterzugeben. Eine veröffentlichte Fallstudie beschreibt eine Untersuchung. Sie erlaubt nicht automatisch jedem Leser, diese zu wiederholen.
Mein erster Versuch wäre eine Funktion in einer kleinen App, die mir gehört, oder in einem passend lizenzierten Open-Source-Projekt. Damit bleiben das Ziel überschaubar und das Ergebnis leicht überprüfbar.
Mich begeistert die Möglichkeit, aus „Wie haben die das wohl gemacht?“ eine Erklärung zu gewinnen, die ich untersuchen, hinterfragen und verwenden kann. Ein gutes Ergebnis gibt mir einen klareren Ausgangspunkt, um meine eigene Idee zu bauen. Das ist für mich schon ziemlich viel wert.
Quellen und Repository-Dateien wurden am 11. Oktober 2026 geprüft. Die veröffentlichten Ergebnisse der Fallstudien stammen von den verlinkten Projekten. Die Suchübung, der Ablauf für das alte Hilfsprogramm, das Codebeispiel zum Projektilring und der Einstiegsprompt sind illustrative Beispiele für diesen Artikel.